KADAI INFOに「あなたへのおすすめ」ができるまで ― AIレコメンド開発の裏側
こんにちは。KADAI INFOのエンジニアの植村と清田です。
突然ですが、SNSの「あなたへのおすすめ」をついつい見続けてしまった経験はありませんか?
今や当たり前すぎて意識することも少ない機能ですが、レコメンドの精度しだいで、再生回数や売上が大きく変わるそうです。レコメンドがなく、自分でキーワード検索して見つけないといけないなら、YoutubeやTikTokなどは今のように成功しなかったかもしれません。
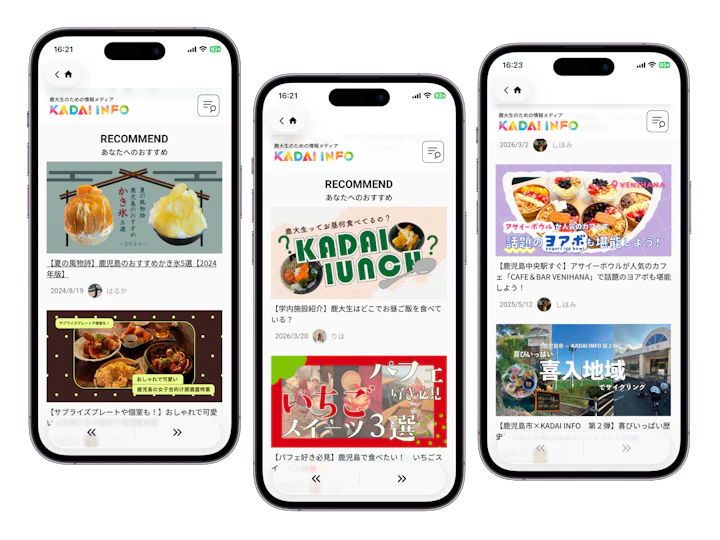
KADAI INFOには現在800本以上の記事があり、編集部が厳選した記事を手動で設定してレコメンドしています。
しかし、
・手動で選ぶのは手間がかかること
・一部の記事だけがおすすめされること
・過去の記事が発見されづらいこと
などの課題がありました。
そこで、機械学習(AI)を使って、読者の閲覧履歴から読者それぞれの興味に合った記事をおすすめするレコメンド機能を実装しました。
あれこれ悩みながら作ったので、ぜひ読んでもらえると嬉しいです🙌
KADAI INFOエンジニア部は、学生だけのチームでこんなことをやってます!一緒にサービスを作ってみませんか?
https://kadaiinfo.com/about-us
AI(レコメンドモデル)の学習データの収集
突然ですが、AIは、過去の膨大なデータからパターンを学習し、そのパターンをもとに未知のデータに対して予測(推論)を行います。
「むかしむかし、あるところに、」という文章には後に何が続きそうですか?「おじいさんとおばあさんが住んでいました。」ですよね。これは私たちが、桃太郎を読んで、次に何の単語が続くと自然な文章になるかを覚えているからです。
今話題のChatGPTやGeminiなどのLLMも、たくさんの文章を学習して、次にくる確率の高い単語を予測しているんですね。
それと同じように、過去に読者が記事をどんな順番で読んだかというデータを大量に集め、その傾向から、次に読まれる記事を予測すれば、読者が読みたい記事を自動でレコメンドできるのではないか、という方針を立てました。
AI(以下、レコメンドモデル)の学習に使うため収集したデータは、次の2種類です⬇️
① 閲覧履歴データ
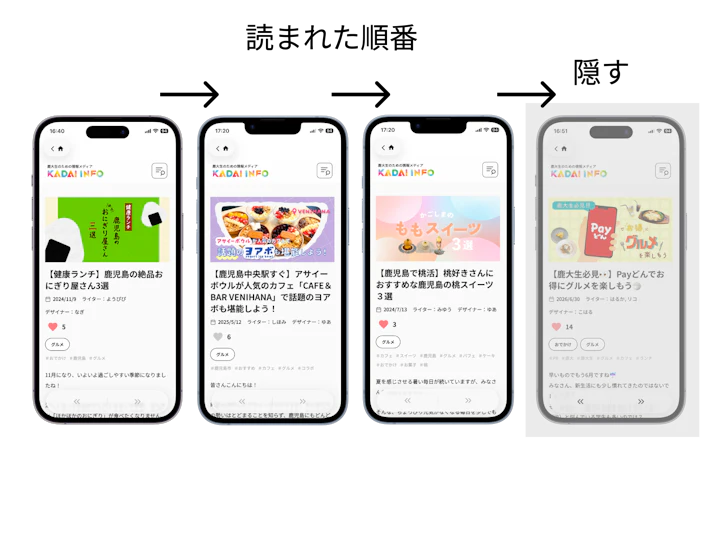
読者がどの記事をどの順番で読んだかの履歴。アクセス解析ツールのGoogle Analyticsを使い、2025年7月10日から2026年9月6日までの約14か月間を対象に、匿名で4,000件以上収集しました。各履歴のうち最後に読まれた記事を隠し(マスクし)、それ以前の記事から最後の記事を予測するための学習用のデータとして使います。
② 記事データ
過去10年間に投稿された記事のデータ。記事ID、タイトル、カテゴリ、タグ、ライター、公開日時など。後ほど説明するレコメンドモデルに入力する特徴量の生成に使います。800記事以上収集しました。
レコメンドモデルの構築
最終ゴールは、読者がまだ読んでいない全ての記事に対して、読者がその記事をどれくらい読みそうかのスコアを算出することです。
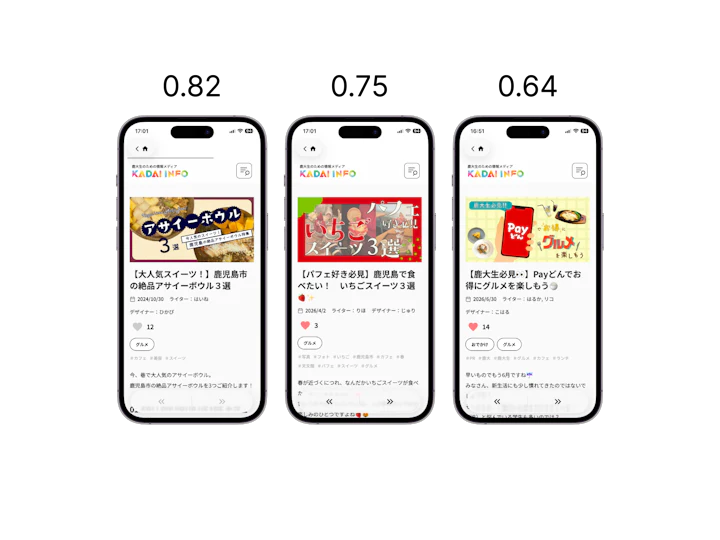
そのために、レコメンドモデルには、閲覧履歴をもとに実際に最後に読まれた記事を隠して、それを当てるタスクを解かせます。僕たちが高校生の時に、たくさん模試を解いて、本番の試験に挑んだのと一緒ですね。
上記のタスクの正解を導くには判断材料が必要です。その材料として、読者がすでに読んだ記事と、まだ読んでいない記事の組み合わせごと、関係性を数値化します(特徴量にします)。
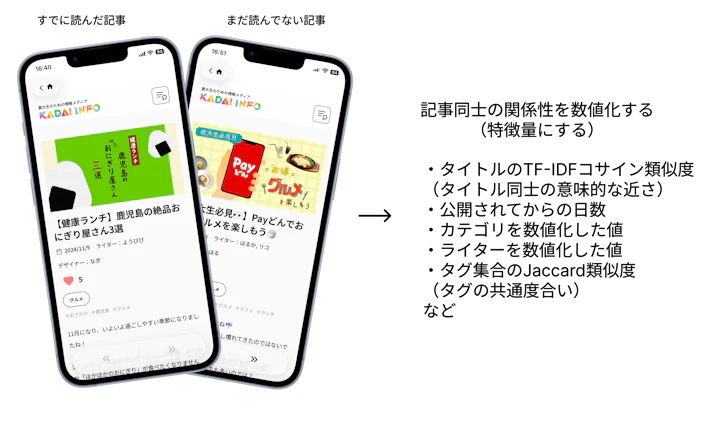
分類 | 特徴量 | 意味 |
|---|---|---|
候補記事 | age_days | 公開されてからの日数 |
候補記事 | category | カテゴリを数値化した値 |
候補記事 | writer | ライターを数値化した値 |
候補記事 | n_tags | タグ数 |
直前の記事との関係 | shared_tags_last | 共通タグ数 |
直前の記事との関係 | tag_jaccard_last | タグ集合のJaccard類似度 |
直前の記事との関係 | title_similarity_last | タイトルのTF-IDFコサイン類似度 |
直前の記事との関係 | same_category | 同一カテゴリなら1、異なれば0 |
履歴全体との関係 | shared_tags_max | 履歴記事との共通タグ数の最大値 |
履歴全体との関係 | title_similarity_max | 履歴記事とのタイトル類似度の最大値 |
履歴全体との関係 | title_similarity_mean | 履歴記事とのタイトル類似度の平均値 |
履歴全体との関係 | same_category_ratio | 履歴中で候補と同じカテゴリの記事割合 |
履歴全体との関係 | same_writer | 同じライターの記事が履歴に存在するか |
公開日の関係 | published_gap_min_days | 履歴記事との公開日の差の最小値 |
など |
上記の特徴量をレコメンドモデルに入力し、レコメンド対象となる記事に対して、読者がその記事をどれくらい読みそうかのスコアを算出します。
読まれていない記事よりも最後に読まれた記事を上位にスコアリングすることができればOK、できなければNGといった具合です。
今回の例で言うと、「Payどんでお得にグルメを楽しもう🍚」の記事のスコアが、他の記事のスコアよりも高くなれば成功です。
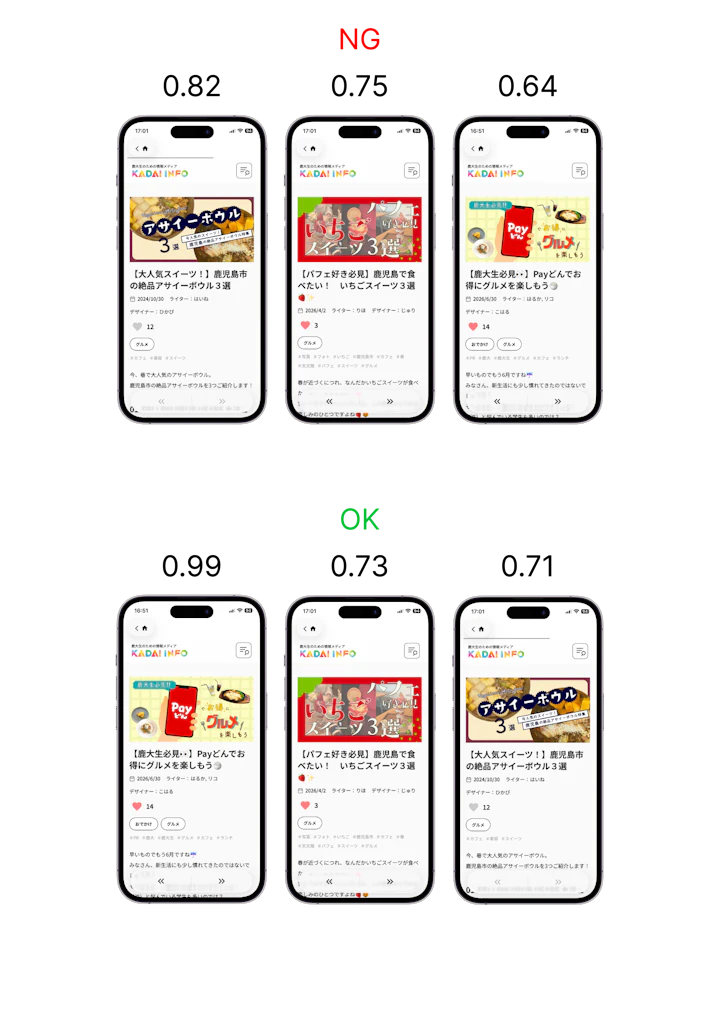
具体的には、LightGBM(機械学習モデル)をLambdaRank(ランキング学習)と呼ばれる手法で学習させます。実際に最後に読まれた記事(正解記事)と、それ以外の記事のスコアを比較し、
正解記事のスコアが他の記事より上位になるほどレコメンドモデルに与えるペナルティは小さくなり、正解記事が下位になるほど損失は大きくなります。
また、上位順位での間違いほど影響が大きいため、強いペナルティが与えられます。
損失は以下の式で表されます。
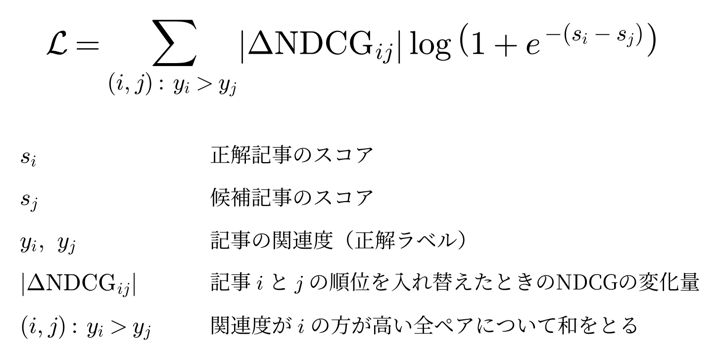
学習の過程で、レコメンドモデルはこのペナルティを最小化する方向へと最適化され、適切な記事に高いスコアをつけることができるようになります。
このように、閲覧履歴をもとにレコメンドモデルを構築することで、読者が今後読む可能性のある記事をレコメンドすることができるようになりました。
レコメンドモデルの評価
学習させたレコメンドモデルのレコメンド結果が良いものかどうかを判定するため、学習に用いていないデータ(テストデータ)を用いて定量評価を行いました。具体的には、学習用80%、テスト用20%へ分割し、テストデータに対して次の指標を算出しました📍
・Recall@4:正解記事が推薦上位4件に入った割合
・Precision@4:推薦した4件のうち正解記事が占める割合
・NDCG@4:正解記事が上位にあるほど高くなる指標
・MRR@4:正解記事の順位の逆数を用いた指標
指標については以下のページを参考にしました!
https://zenn.dev/hellorusk/articles/7e336fd3c6be20a8f8d1
実装してみての課題
ここまでで一通りレコメンドが完成して、閲覧履歴との関連性が高い記事をレコメンドできるようになりましたが、いくつか問題が浮上しました🧐
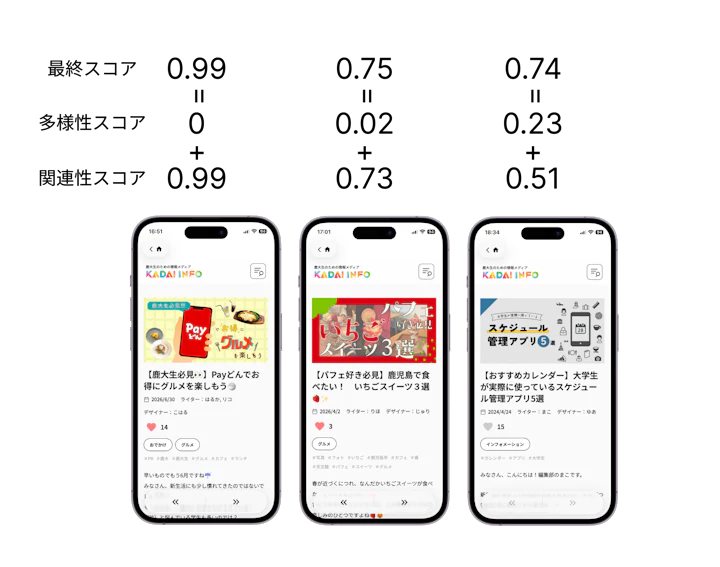
まず、スコア上位数件に、非常に似た内容の記事が偏る場合がありました。精度よくレコメンドできている反面、数枠の中にもっと幅広い種類の記事をレコメンドした方が、読者が新たなジャンルの記事を発見するのをサポートできるのではないかと考えました。
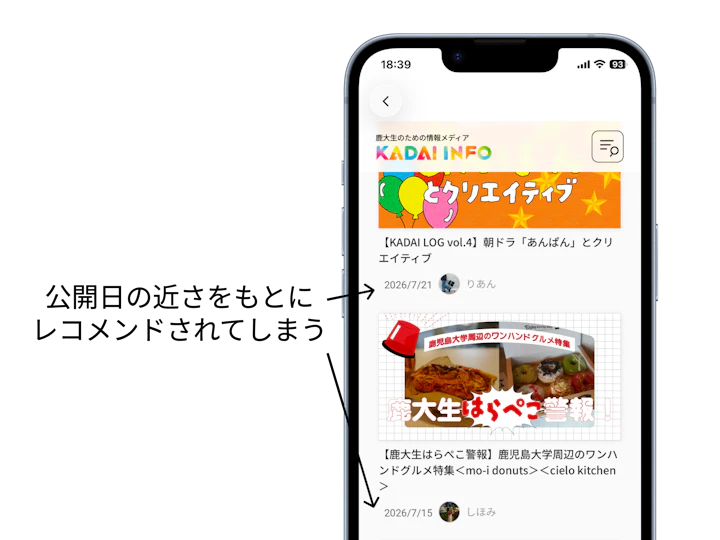
また、内容の近さだけでなく公開時期の近さが強く反映されることがありました。Webページの構造上、公開日が近い記事が並んで表示されるため、読者は興味と関係なく公開日順に記事を閲覧します。そのバイアスをレコメンドモデルが学習してしまいました。
そこで追加の実装として、非常に似た記事をレコメンドするモデルAと、多様性を持たせてレコメンドするモデルBを並列で動かし、その結果を最終的にレコメンド結果にする案を考えました。
似た記事をレコメンドするモデルA
公開時期の近さのバイアスを除き、似た記事をレコメンドするモデル
多様性を持たせたレコメンドをするモデルB
DPP(Determinantal Point Process、行列式点過程)と呼ばれる手法を用いて、記事に多様性を持たせてレコメンドするモデル
DPPの理論についてはこちらの記事を参考にしました!
https://qiita.com/grouse324/items/e0d26b392242cafc85b6
DPPで使う「記事同士の似ている度合い」S(i, j)は、タイトルとタグの2つから求めています。
S(i,j) = α × タイトル類似度(i,j) + (1-α) × タグ類似度(i,j) (α:固定)タイトルの類似度は、TF-IDFで単語の重要度を数値化し、そのコサイン類似度で計算しています。タグ類似度は、有無を0/1でベクトル化し、同様にコサイン類似度で計算しています。
DPPは、すべての組み合わせを計算すると処理が重くなり、レコメンドの表示が遅れる恐れがありました。そこで、計算の過程で貪欲的に選ぶ近似を使いました。さらに、コレスキー分解の結果を再利用して高速化しました(Fast Greedy DPP)。
レコメンドモデルのWebサイトへの組み込み
上記の方法で学習させたレコメンドモデルを、バックエンドサーバー上でAPIとして動作させました。
学習済みモデルと記事情報をバックエンドに配置し、フロントエンドから閲覧履歴をバックエンドに送信することで、レコメンド結果をWebサイト上に表示する構成になっています。
ユーザーが記事を開いてから、レコメンドが表示されるまでの流れは次のとおりです。
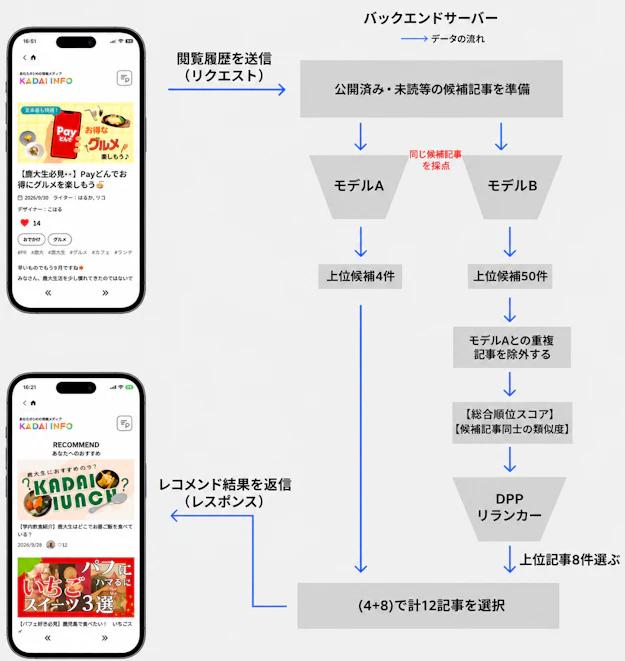
① フロントエンドが、そのブラウザに保存された直近20件の閲覧記事IDをバックエンドサーバー(CloudFlare Workers)のAPIへ送信(リクエスト)
② バックエンドサーバーが、公開済み・未閲覧の記事を候補とし、閲覧履歴と記事データから候補記事ごとの特徴量を生成する
③ 学習済みのモデルA(14特徴量)とモデルB(公開日の差の情報を除いた13特徴量)で、それぞれランキングスコアを計算する
④ モデルAの上位4件を確定する。モデルBの上位50件から重複を除き、確定した4件との類似度も考慮しながら、Fast Greedy DPPで8件を追加する
⑤ 選択した計12件の記事ID・タイトル・URLなどをJSON形式でフロントエンドへ返す(レスポンス)
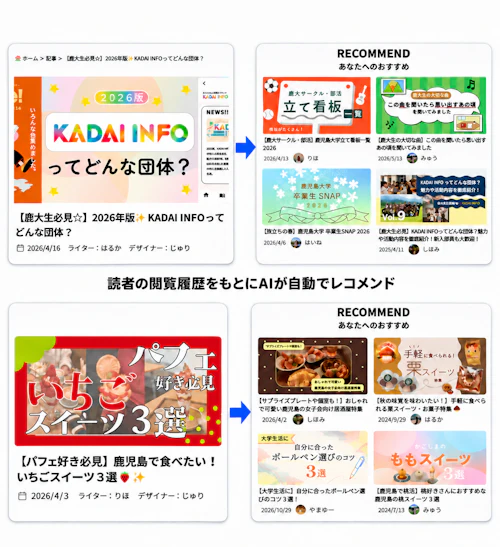
⑥ フロントエンドが表示に必要な記事情報をそろえ、記事ページ下部の「あなたへのおすすめ」に表示する
また、レコメンドの表示までの時間を短縮するために以下の工夫を施しました。
・モデルやデータは、バックエンドサーバーの起動時に一度だけ読み込み、以降のリクエストではメモリ上のデータを使い回す
・タグやタイトルのベクトルをあらかじめ計算した形式で保存し、リクエストごとのベクトル化処理をなくす
・決定木を配列形式で保存し、機械学習ライブラリを介さず計算する
など
その他にも、microCMS WebhookとGitHub Actionsを使い、レコメンド対象とする記事データの更新を自動化しました。
①microCMSで記事を公開・更新する
②WebhookでGitHub Actionsが起動する
③公開記事を全件取得し、推薦用の記事データを再生成する
④Cloudflare Workersに記事データを再デプロイする
今後の課題
今回のレコメンドの構築には、過去の閲覧履歴を利用しました。
そのため、これまでのおすすめ記事が編集部の選んだ一部の記事に限られていたことや、
サイトの動線上、公開日の近い記事が続けて読まれやすいことから、学習データ自体に偏りがあり、そのバイアスをモデルが学習しています。
また、実際にモデルを構築する中で、過去の閲覧履歴への評価(RecallやNDCGなどのオフライン評価)が高くても、実際の読者にとって自然で魅力的な推薦になるとは限らないことがわかってきました。
今後は、実際のクリック率や読者の反応も確認しながら、改善していけたらと思います。
また、推薦候補の記事の更新は自動化していますが、モデルの再学習は手動で行う必要があります。
読者の興味や記事の傾向は時間とともに変化するため、閲覧履歴の収集から再学習、評価、デプロイまでを定期的に行う仕組み(MLOps)の構築にも取り組んでいます!
まとめ
今回、読者の閲覧履歴をもとに記事を順位付けするモデルを構築し、実際のWebサイトでレコメンド結果を表示する仕組みを実装しました。また、2種類のモデルを組み合わせる方式により、関連性を保ちながら、似た記事ばかりが並ばない推薦を目指しました。
一方で、レコメンドモデルは作って終わりではないことに気づくことができました。実際の利用データをもとに評価と再学習を繰り返し、読者と編集部の双方にとってより良い推薦へ改善していきたいです。
「あなたへのおすすめ」をきっかけに、これまで知らなかったKADAI INFOの記事を見つけてもらえたらうれしいです!
おすすめ記事を読み込んでいます...